Opus 5.5、Fable 5.1 和 GPT-6 Astra 都针对高要求的人工智能工作。这并不能让他们为你的下一个项目做出平等的选择。价格、工具、任务质量和审核时间可能指向不同的方向。
此比较使用 9 月23、2026 检查的官方文档。它是对已发布的规范和工作流程权衡的比较,而不是独立的基准。 OpenAI的正式名称为GPT-6 Astra;我们自始至终都使用这个名字。
已发布的规格
该表显示了以美元为单位的标准基本 API 令牌费率。 M 表示一百万个代币。它不包括缓存折扣、特殊模式、工具费用和长投入附加费。
资料来源: Opus 5.5 规格, 寓言5.1规格, 和 GPT-6 Astra 规格.
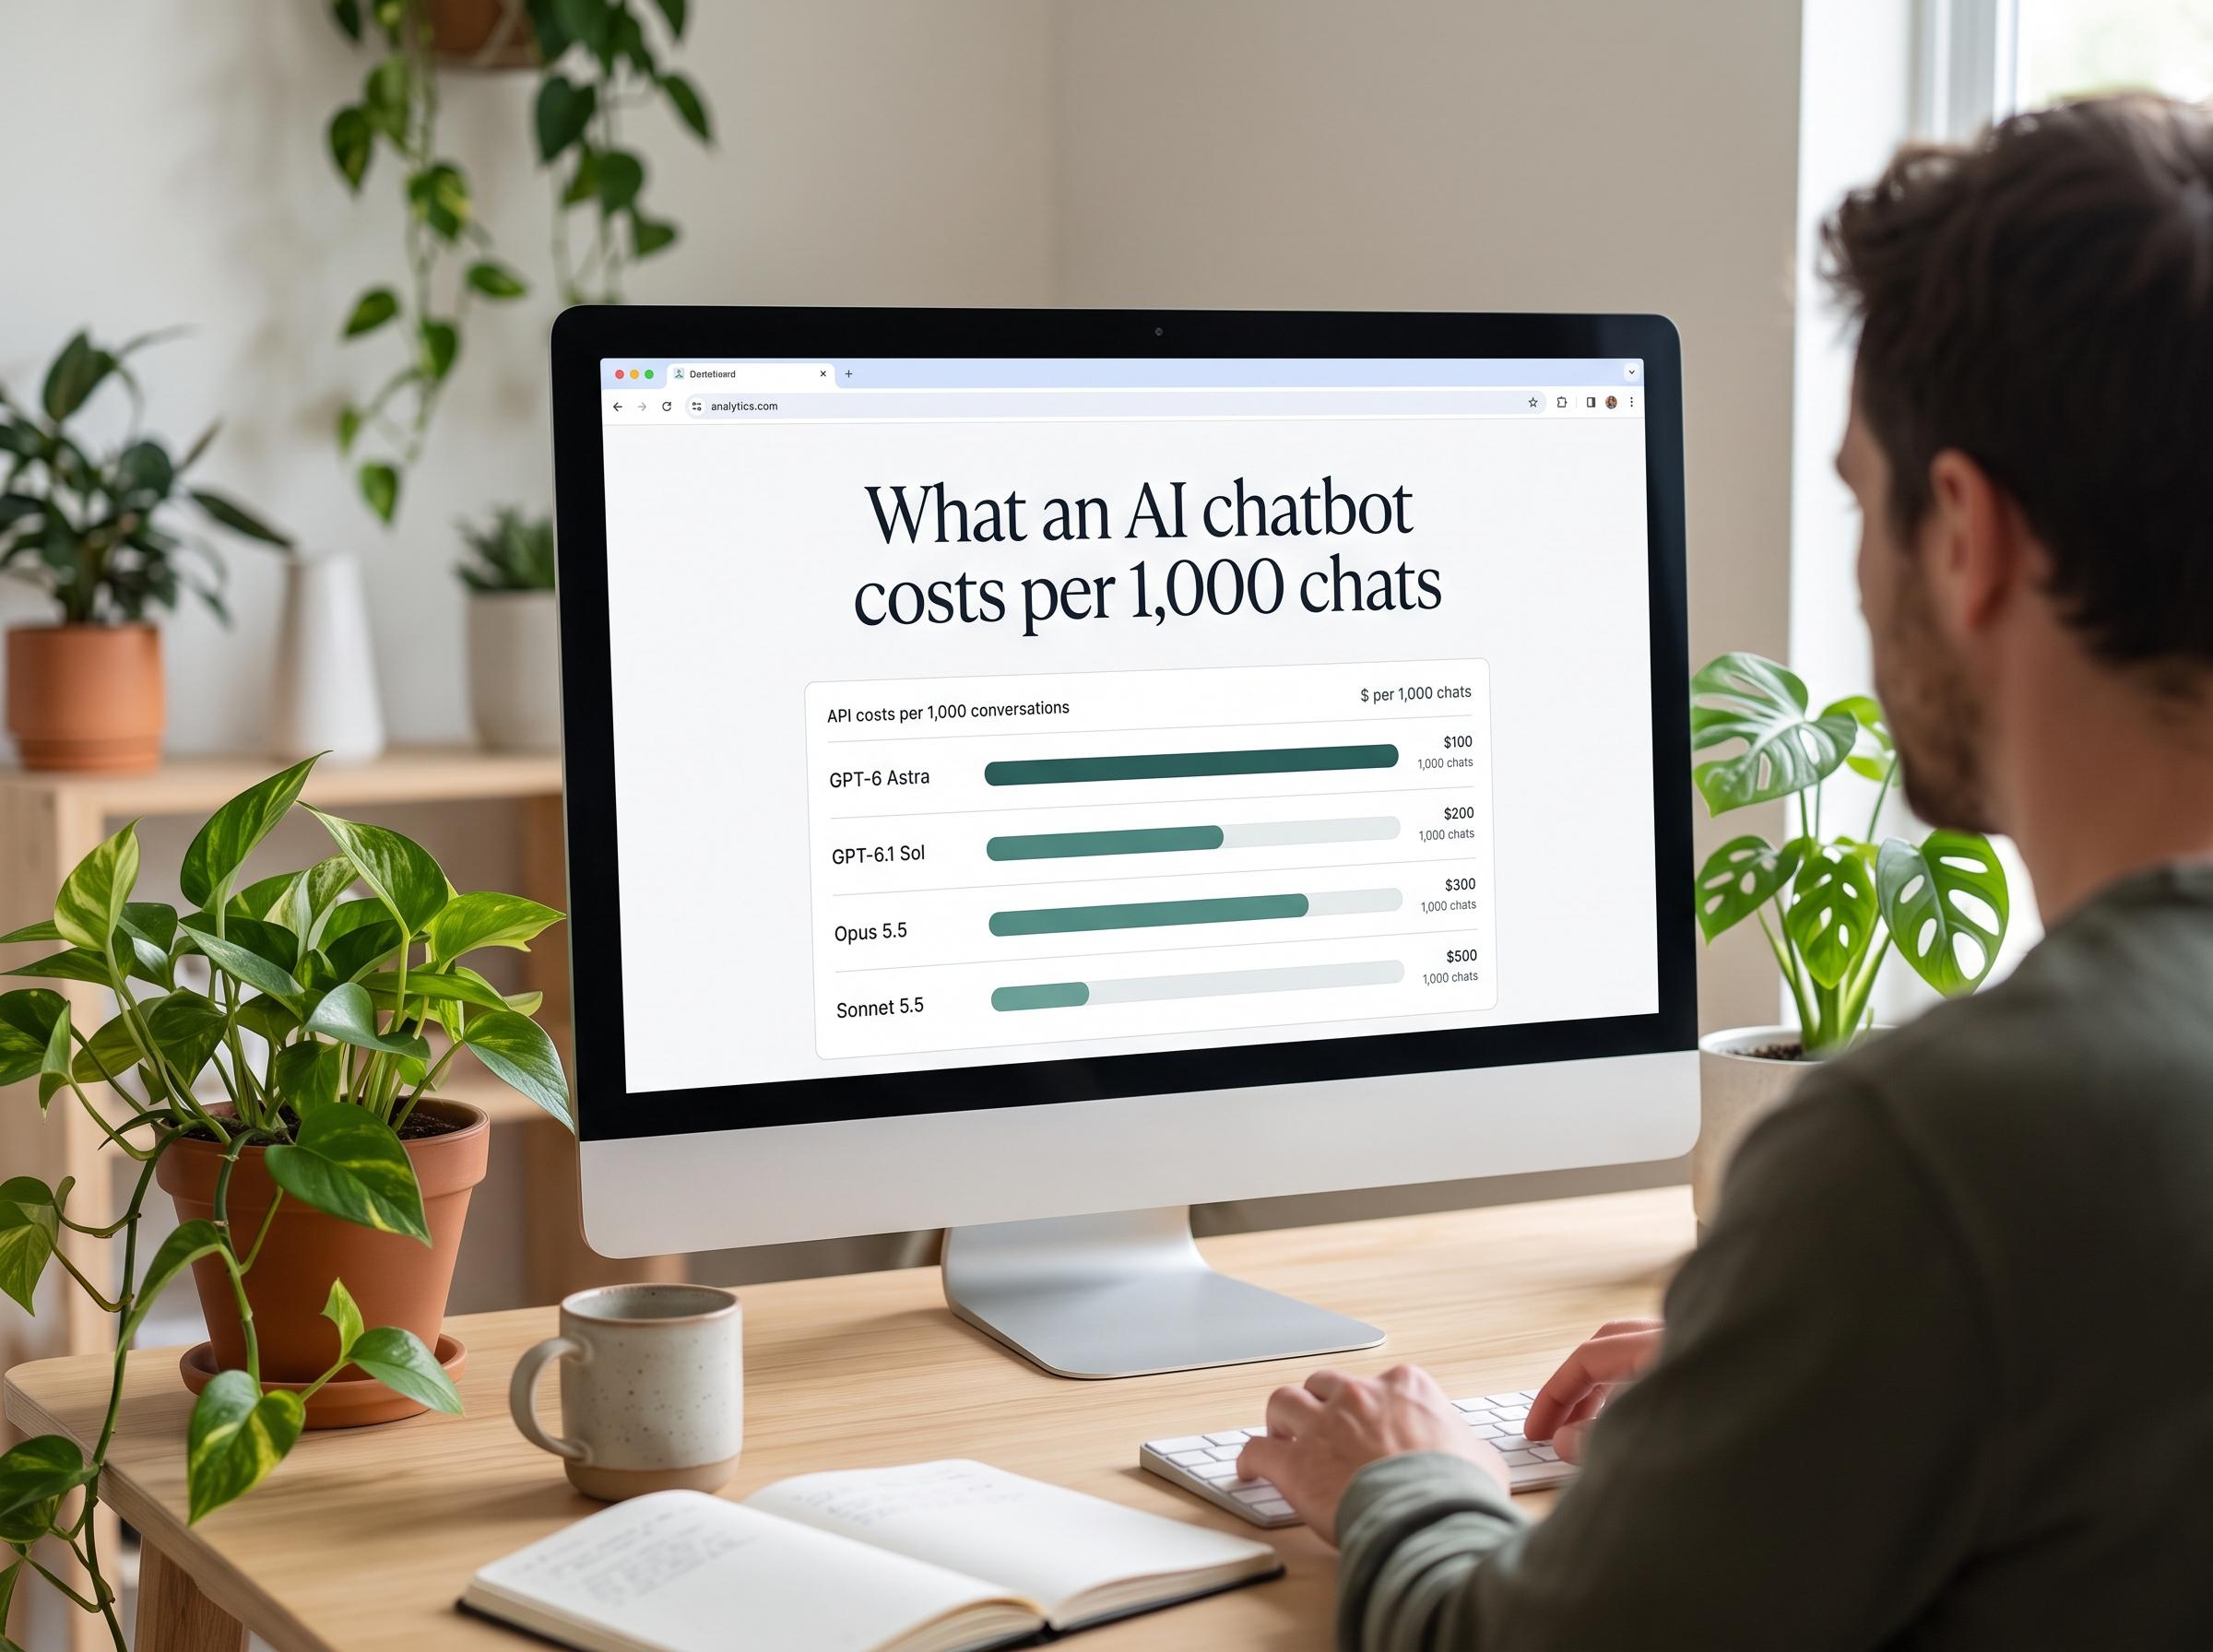
价格差距一目了然。按照列出的基本费率,Opus 每个输入或输出代币的成本比其他两者低 60%。这是根据费率算出的,并不是说每项完成的任务都会花费 60% 少。
上下文限制就是容量限制。仅当您的任务需要并且模型可以很好地使用材料时,稍大的窗口才有用。
从您需要完成的任务开始
对于常规代码更改或文档工作流程,当成本很重要时,Opus 5.5 是测试的明智首选。这是我们基于其较低的列出价格的建议,而不是经过衡量的质量胜利。
寓言5.1值得在改进概要并测试成本较低的选项后仍然存在错误的工作中进行测试。 Anthropic 将其定位于要求严格的推理和长期运行的代理工作。确定任何质量收益是否可以弥补更高的费用。
当你的工作已经依赖于 OpenAI 的工具和 API 时,Astra 值得一试。其模型页面列出了对诸如通过 Responses API 进行网页搜索、文件搜索和计算机操作等工具的支持。现有的集成节省的工作量可能比模型价格上的微小差异还要大。
我们的 AI 集成服务 可以帮助将该候选名单转变为有界测试。有关更多产品背景,请参阅我们的 Astra 介绍.
通过一个清晰的例子来比较成本
假设每个模型使用 100,000 个未缓存的输入 Token 和 10,000 个计费输出 Token。使用标准基础费率,不进行工具调用,也不进行重试。
- Opus 5.5:$0.40 输入加上 $0.20 输出,$0.60。
- 寓言5.1:$1.00输入加上$0.50输出,$1.50。
- GPT-6 Astra:$1.00 输入加上 $0.50 输出,$1.50。
这是一个说明,而不是对代币使用的预测。提供者以不同的方式对文本进行标记,并且每个模型可能采取不同数量的步骤。推理和重试可以增加计费输出。
Astra 在输入超过 272,000 个 Token 时也会改变费率:整个请求的输入和缓存费率会翻倍,而输出费率则会增加一半。该阈值不会影响此示例。在对大型文档工作进行定价之前,请检查你的实际提示词大小。
让这些想法落地。
从解决具体问题到建设完整网站,我们帮助您明确范围并完成实施。
聊聊我的网站定制网络和应用程序开发分享您的目标。我们通常会在 4 小时内回复相关问题及实用的下一步方案。
工具可以改变答案
模型不会仅仅因为能够描述集成过程就去运行它。周边的应用程序必须提供工具、凭据、错误处理和明确的权限。
如果您的工作流程已在某个提供商的堆栈中运行,请估算移动它的成本。包括工具模式、流式传输、保存的对话状态、日志记录和测试。较低的代币利率可能需要时间来回报这项工作。
对于 Claude 升级,请检查当前的迁移说明。 Opus 5.5 和 Fable 5.1 在思维和强制工具使用方面有特定于模型的规则。不要假设旧请求可以在不进行更改的情况下切换模型名称。
我们的 API 和后端开发服务 涵盖了围绕这些连接的工程。
不要从一张图表中选出获胜者
基准测试结果取决于任务集、工具、提示词、工作量设置和评分规则。厂商的图表可以帮助你选择测试对象,但无法确定哪款模型最适合你的网站。
例如,模型可能在代码任务上得分很高,但仍然错误地处理插件的边缘情况。强有力的研究答案可能需要很长时间才能获得实时客户支持。
使用我们的 早期 Astra 和 Claude 比较 对于历史背景。让这个新的决定与当前的文档和您自己的结果相关联。
一下午进行公平审判
从近期的工作中选择十个任务。包括常见任务、一些困难案例以及一个正确响应是询问缺失信息的任务。
为每个模型提供相同的简介和源材料。记录准确的模型、工具访问和工作量设置。使用适合预算的设置,并报告任何差异。
- 对结果是否正确、完整进行评分。
- 记录可用答案的时间,而不仅仅是第一个标记。
- 统计所有调用、重试和工具费用。
- 请注意一个人花多长时间查看结果。
- 重复接近的结果,这样一个幸运的答案就不会决定选择。
我们的 工作流程自动化服务 可以帮助捕捉这些措施。使第一次试验足够小,以便有人可以审查每个输出。
选择一个默认模型和一个升级的理由
您的团队可能会在大多数工作中使用一种模型,而在一小部分困难任务中使用另一种模型。写下触发第二次尝试的信号。失败的测试或丢失的源比“这感觉很复杂”更有用。
选择能够以可接受的总成本满足您的质量标准的型号。当工作负载、价格或模型发生变化时,重新检查该选择。
常见问题
哪种模型的 API 代币基础价格最低?
在这三者中,Opus 5.5 的公布标准基本费率最低(9 月23、2026 检查)。实际任务成本还取决于代币使用、工具、重试和定价选项。
Fable 5.1 和 GPT-6 Astra 的价格一样吗?
他们列出的标准基本费率为每百万输入代币10美元和每百万输出代币50美元。缓存定价、长输入规则、工具和实际使用情况可能有所不同。
哪种模型最适合编码?
本文并没有建立实际的获胜者。测试相同的真实代码任务并比较通过的测试、审核工作量、时间和全部成本。
我可以在工作流中使用多个模型吗?
是的。您可以路由任务或升级失败的案例,但每个集成都需要测试。仔细保留任务上下文并检查额外尝试的成本。