模型发布公告可以告诉你应该调查什么。它无法告诉你模型将如何处理你最古老的集成、你的测试设置,或是从未被记录下来的需求。
在更改团队的默认编码工具之前,针对类似于你真实待办事项的工作进行小型评估。将结果视为针对你项目的证据,而不是通用的排行榜。
选择具代表性的任务
选择一个Bug修复、一个小功能以及一段代码解释。使用具有已知预期结果的工作和一个安全的测试环境。
避免使用全部由简单的格式更改组成的测试集。同时,避免让一个模型去完成另一个模型已经在同一对话中解决过的任务。
保持条件具有可比性
使用相同的起始修订版、简短的、允许的工具和时间范围。记录测试期间可用的确切型号和配置。
包含相关的项目说明,但在不加说明的情况下,不要中途给某个候选者提供额外的提示。不平等的帮助会使对比结果难以解读。
评估变化,而不是信心
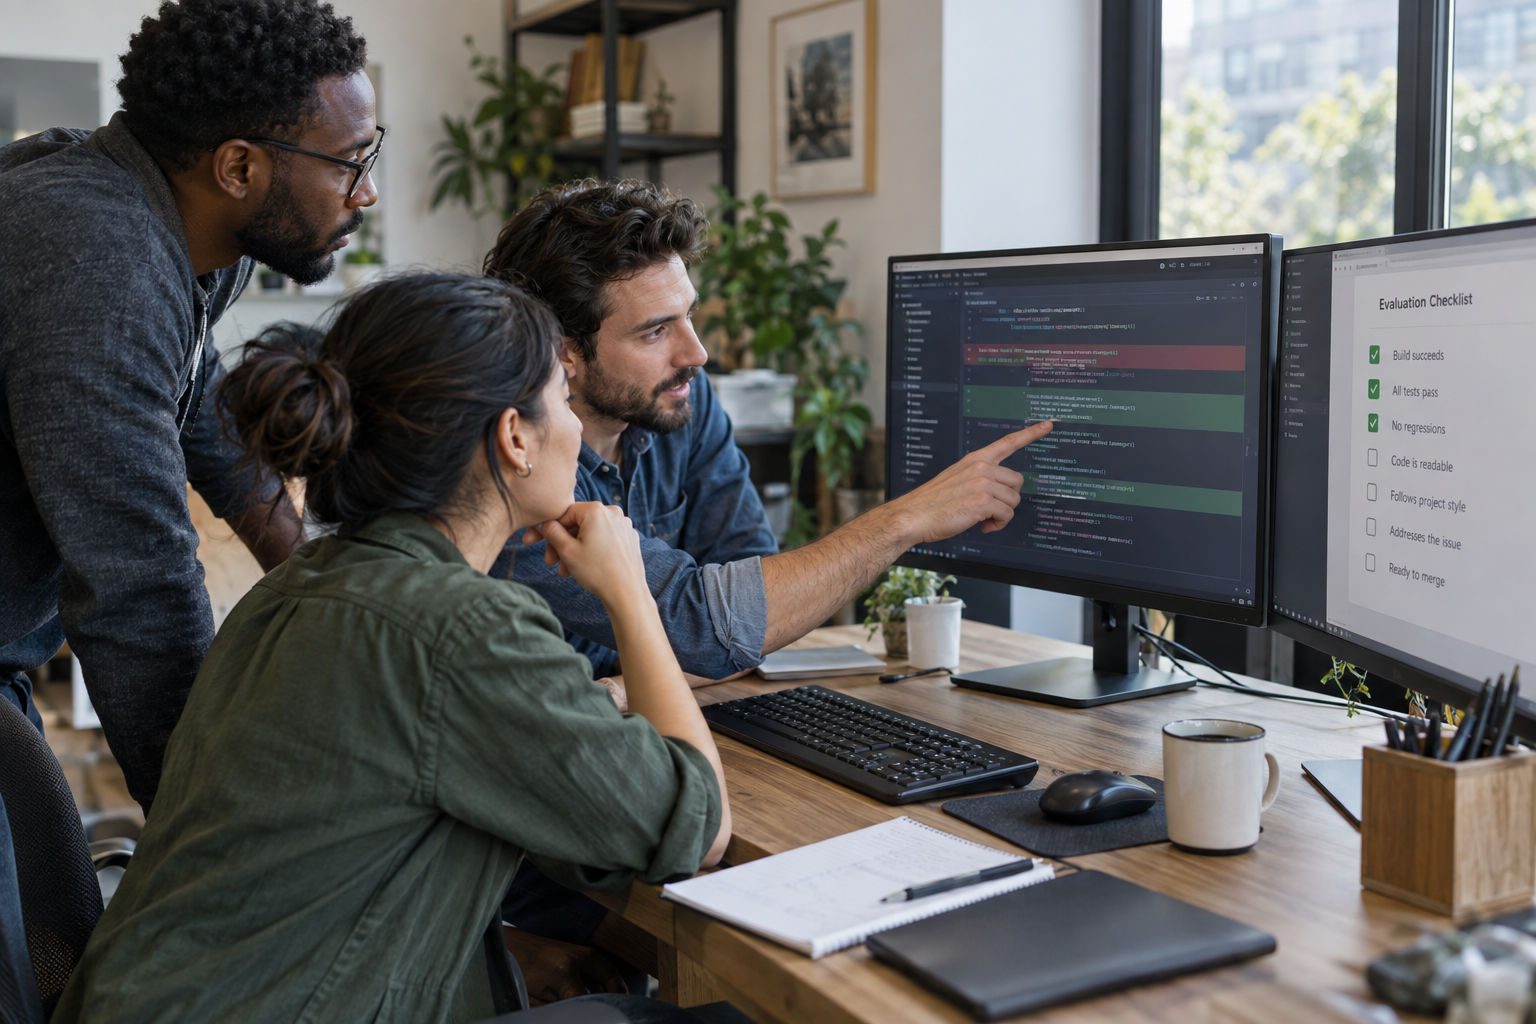
检查输出是否符合验收标准、是否保留了现有行为,以及是否遵循了商定的范围。阅读代码差异(diff)并运行相应的测试。
Anthropic 的 编码最佳实践 提供特定于工具的验证上下文。您的评估仍然需要围绕您自己的应用程序设计的检查。
让这些想法落地。
从解决具体问题到建设完整网站,我们帮助您明确范围并完成实施。
聊聊我的网站定制网络和应用程序开发分享您的目标。我们通常会在 4 小时内回复相关问题及实用的下一步方案。
在生成后统计工作量
记录审阅时间、更正、失败的尝试和未解决的问题。如果开发人员必须解决不必要的重写,快速的初稿可能会变得昂贵。
我们的 工程提示词指南 是编写更清晰任务的相关起点。在将每次失败归咎于模型之前,请保持即时质量一致。
选择有限的下一步
为模型擅长的任务类型采纳更强的候选者。为重大更改保留人工审查边界,并在工作流发生变化时重复评估。
Premier Sol 的 AI 集成服务 可以帮助界定试验,而 定制网站开发 将验收检查与实际产品行为联系起来。
一项有用的评估可能会得出结论:不同的工具适合不同的任务。这比仅仅因为某个模型的发布图表看起来令人印象深刻而选择它要好得多。
常见问题
初次评估应该使用多少个任务?
从一个小的、有代表性的集合开始,您的团队可以仔细审查。在做出广泛采用决定之前对其进行扩展。
我应该使用公共基准测试分数吗?
将它们用作背景,而不是替代测试您自己的任务、工具和审查要求。
什么应算作失败?
在试验前定义失败标准,包括不正确的行为、未授权的范围更改、缺失的检查以及过多的返工。