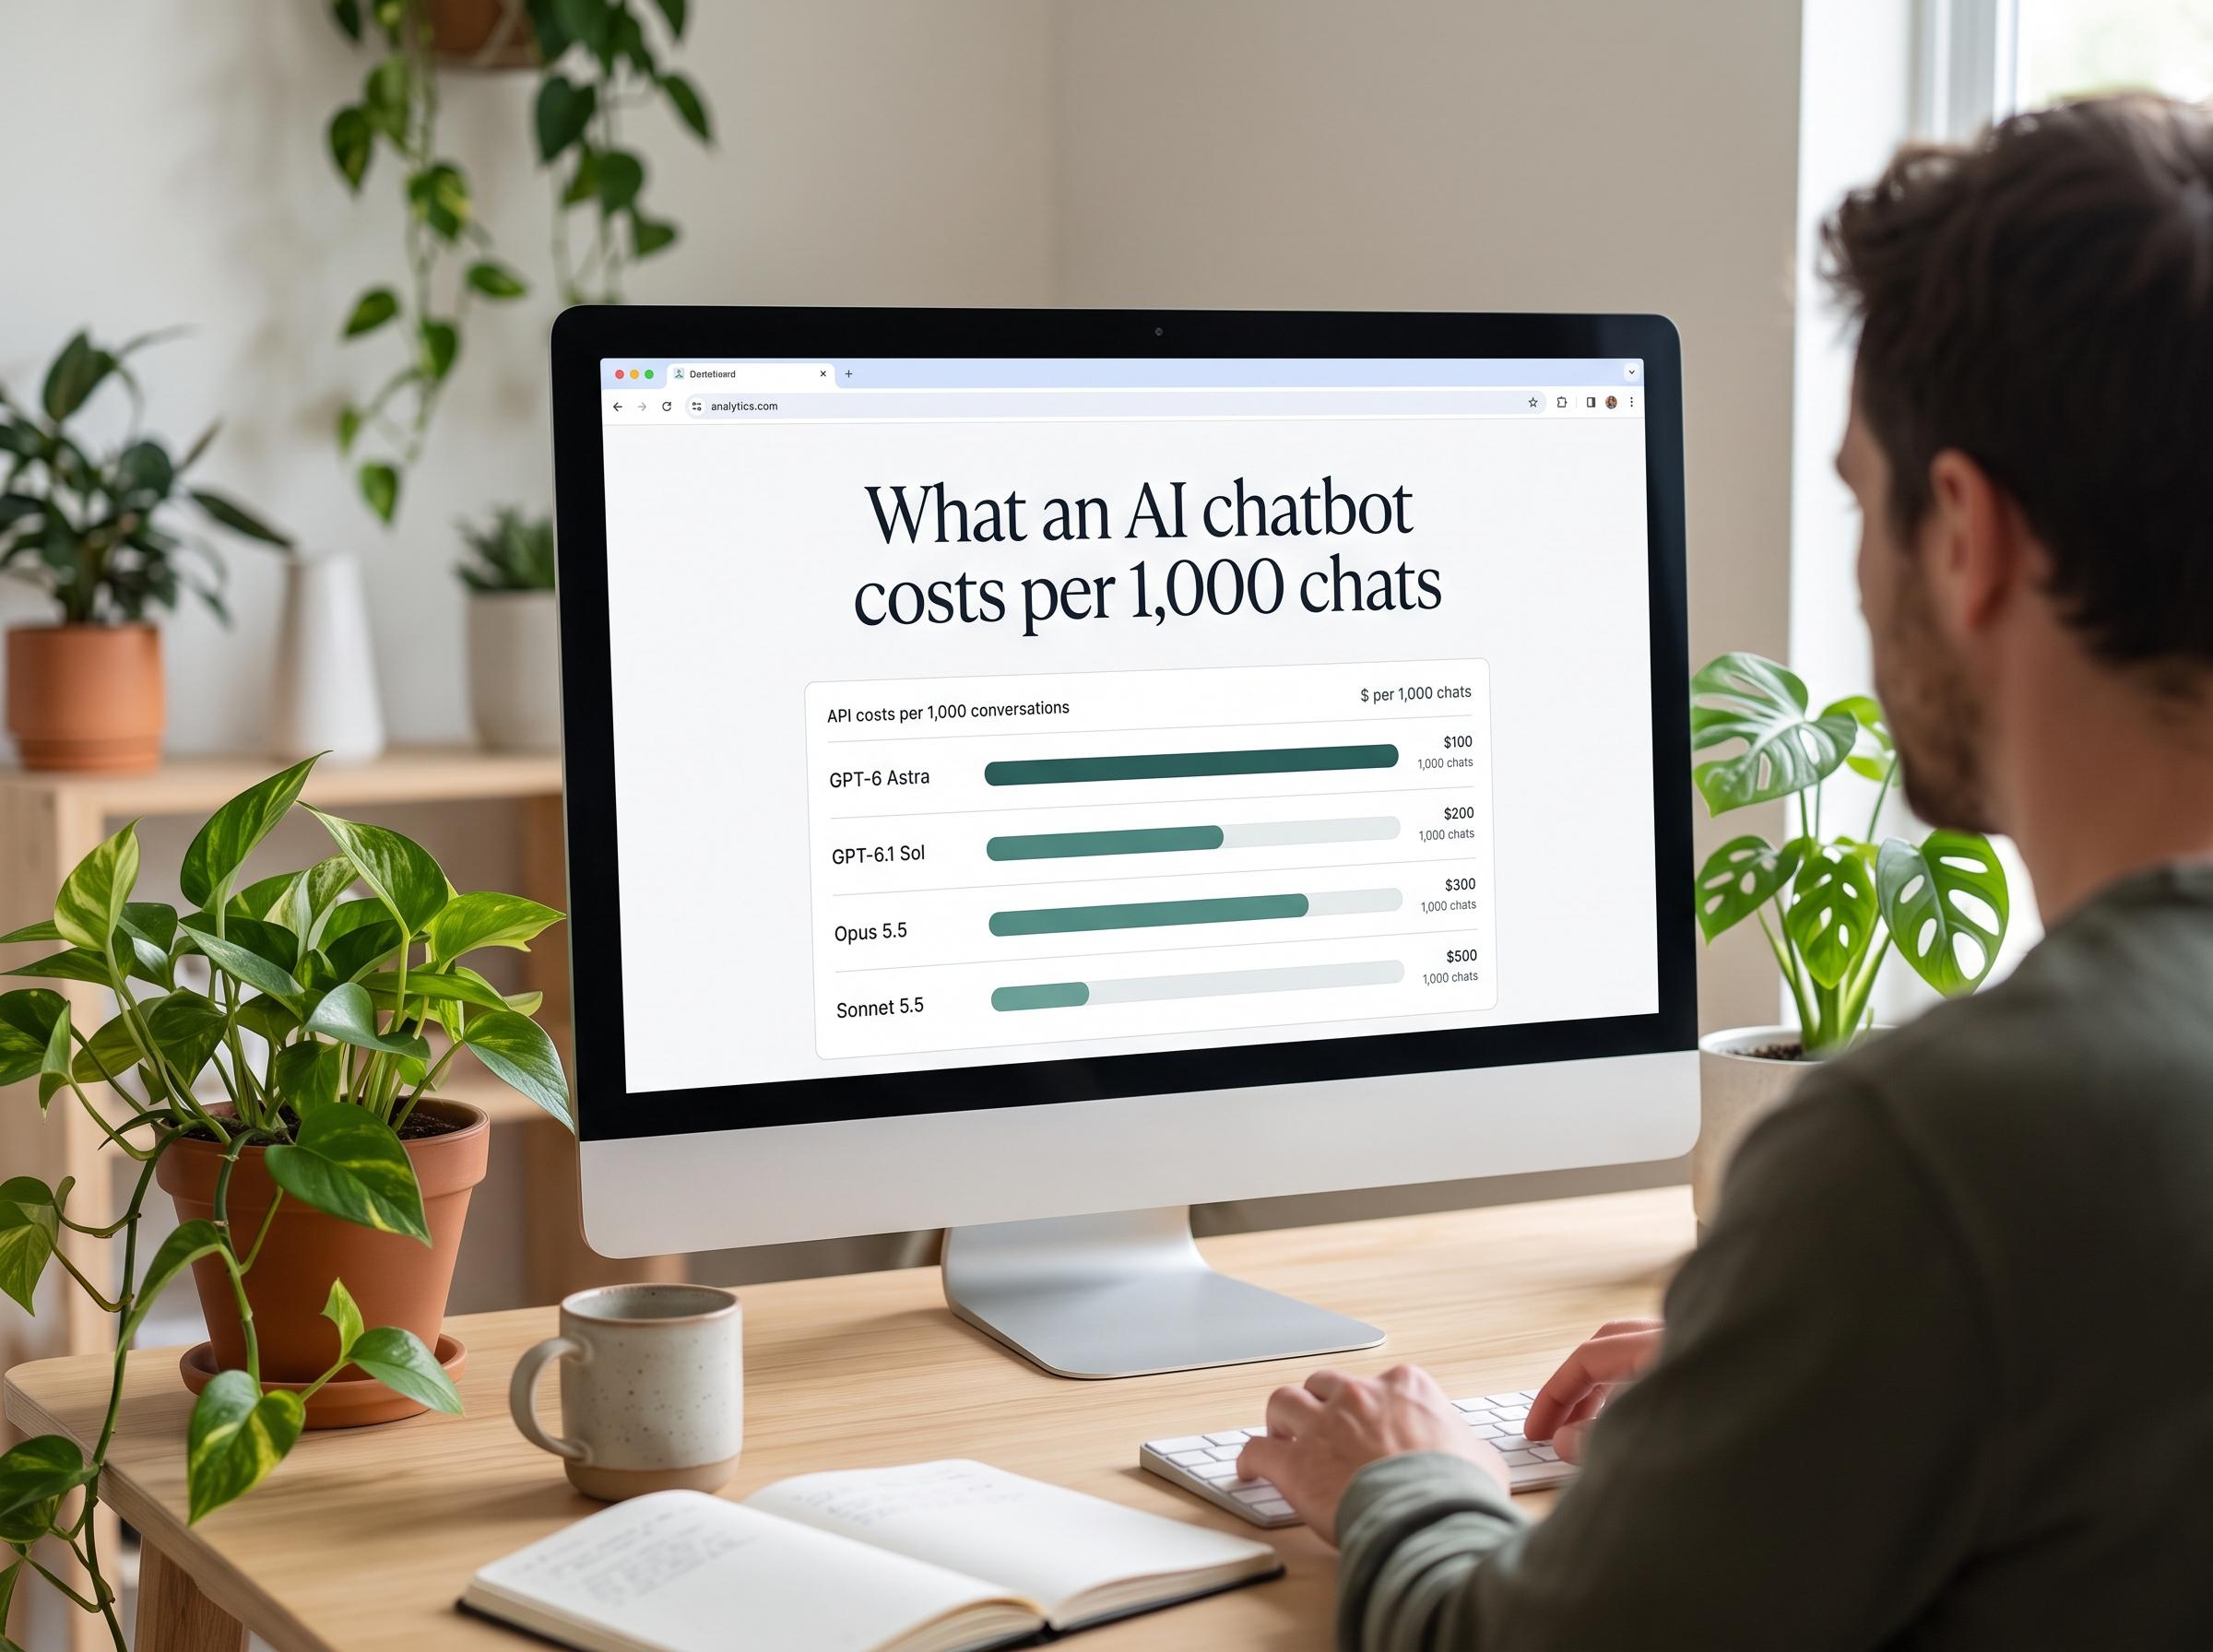
A precios de lista, 1,000 conversaciones de chatbot de 3,000 tokens de entrada y 500 de salida cuestan alrededor de $11 en Claude Sonnet 5.5 o GPT-6.1 Sol, $22 en Claude Opus 5.5, $55 en GPT-6 Astra y alrededor de 55 centavos en GPT-6 Luna. El almacenamiento en caché de un mensaje compartido reduce cada una de esas cifras en aproximadamente un tercio.
Este es solo el modelo de factura y varía según la duración de la conversación. Esta guía muestra el funcionamiento para que pueda reemplazar nuestras suposiciones por las suyas propias.
Los supuestos
- 1,000 conversaciones, cada una con una llamada modelo de 3,000 tokens de entrada (mensaje del sistema, conocimiento recuperado y pregunta del usuario) y 500 tokens de salida.
- Procesamiento estándar a precios de lista en USD, sin descuento por lote ni recargo por contexto largo.
- Para la columna de almacenamiento en caché, 2,000 de los 3,000 tokens de entrada se leen desde la memoria caché al precio de entrada en caché. Se omite el costo único de escribir el caché.
Los chats reales realizan varias llamadas y reenvían el historial cada vez, así que trátelos como un piso.
Precios utilizados
| Model | Input per 1M | Cached input per 1M | Output per 1M |
|---|---|---|---|
| Claude Sonnet 5.5 | $2.00 | $0.20 | $10.00 |
| Claude Opus 5.5 | $4.00 | $0.20 | $20.00 |
| GPT-6.1 Sol | $2.00 | $0.10 | $10.00 |
| GPT-6 Astra | $10.00 | $1.00 | $50.00 |
| GPT-6 Luna | $0.10 | $0.01 | $0.50 |
Fuentes: página del modelo Opus 5.5 de Anthropic y página de precios de API de OpenAI. Los precios de insumos y productos de Sonnet 5.5 provienen de la tabla de comparación de modelos de Anthropic; confirme su precio de entrada en caché en la página Sonnet 5.5 de Anthropic.
El resultado
| Model | Per 1,000 chats | With caching | Per chat |
|---|---|---|---|
| Claude Sonnet 5.5 | $11.00 | $7.40 | about 1.1 cents |
| Claude Opus 5.5 | $22.00 | $14.40 | about 2.2 cents |
| GPT-6.1 Sol | $11.00 | $7.20 | about 1.1 cents |
| GPT-6 Astra | $55.00 | $37.00 | about 5.5 cents |
| GPT-6 Luna | $0.55 | $0.37 | about 0.06 cents |
La aritmética del soneto 5.5 es (3,000 ÷ 1,000,000 × $2 + 500 ÷ 1,000,000 × $10) × 1,000 = $11. Cambia los precios de cada modelo por los demás.
Gemini 4 El argón se excluye porque no está disponible públicamente y los precios informados entran en conflicto.
¿Qué cambia el número?
- Duración de la conversación. Cada turno reenvía el historial, por lo que un chat de diez turnos envía mucha más información que un chat de un turno.
- Almacenamiento en caché. Una lectura en caché es mucho más barata que una entrada nueva, pero escribir la caché cuesta más que una entrada normal: $5 por millón de tokens por una escritura de cinco minutos en Opus 5.5 y $12.50 en GPT-6 Astra.
- Fichas de pensamiento. Opus 5.5 siempre utiliza el pensamiento adaptativo, así que verifique cómo se facturan los tokens de pensamiento antes de confiar en una estimación basada únicamente en la respuesta visible.
- Lote. Ambos proveedores se toman 50% libres para trabajos que no necesitan una respuesta instantánea, como resumir las transcripciones de anoche.
- Herramientas. OpenAI cobra $10 por 1,000 llamadas de búsqueda web además de los tokens.
- Verbosidad. Los modelos utilizan diferentes cantidades de fichas para la misma tarea. En el índice Vals, Sonnet 5.5 cuesta $21.34 por prueba y Opus 5.5 cuesta $32.14, que no es la brecha de 2 a1 que sugieren sus precios de lista. Mida el costo por tarea, no el precio por token.
Pon estas ideas en práctica.
Desde una mejora puntual hasta una web completa, te ayudamos a definir el alcance y llevarlo a cabo.
Hablemos de mi webDesarrollo web y aplicaciones personalizadasCuéntanos tus objetivos. Solemos responder en menos de 4 horas con preguntas y próximos pasos prácticos.
Lo que el proyecto de ley omite
El alojamiento, una base de conocimientos o índice de búsqueda, el seguimiento, la moderación, una ruta de transferencia humana y el tiempo de desarrollo están fuera del proyecto de ley modelo.
Consigue tu propio número en un día
- Muestra 50 preguntas reales de tu bandeja de entrada o tickets de soporte.
- Ejecútelos a través del modelo y registre los recuentos de tokens de entrada y salida que devuelve la API.
- Multiplique el promedio por su volumen mensual y luego agregue un búfer 30%.
- Establezca un límite de gasto mensual en la consola del proveedor antes del lanzamiento.
Preguntas frecuentes
¿El modelo más barato es lo suficientemente bueno para un chatbot de sitio web?
Sólo si pasa tu propia prueba. GPT-6 Luna cuesta una fracción de los demás, pero las respuestas baratas que son incorrectas le cuestan clientes potenciales. Pruebe 50 preguntas reales antes de decidir.
¿El almacenamiento en caché realmente reducirá la factura en un tercio?
Lo hace en este ejemplo, donde dos tercios de la entrada son un mensaje compartido que se lee desde la memoria caché. Su ahorro depende de cuánto se repite cada solicitud.
¿Cuesta más una conversación más larga?
Sí. Todo el historial se envía nuevamente en cada turno, por lo que los tokens de entrada crecen con cada mensaje a menos que lo recortes o lo resumas.
¿Está planeando un chatbot para su sitio?
La elección del modelo es una sola línea. Diseñamos toda la construcción, desde la recuperación y las barreras de seguridad hasta el registro y los límites de gasto, para los sitios WordPress y Next.js. Vea nuestro servicios de integración de IA y desarrollo de chatbots.