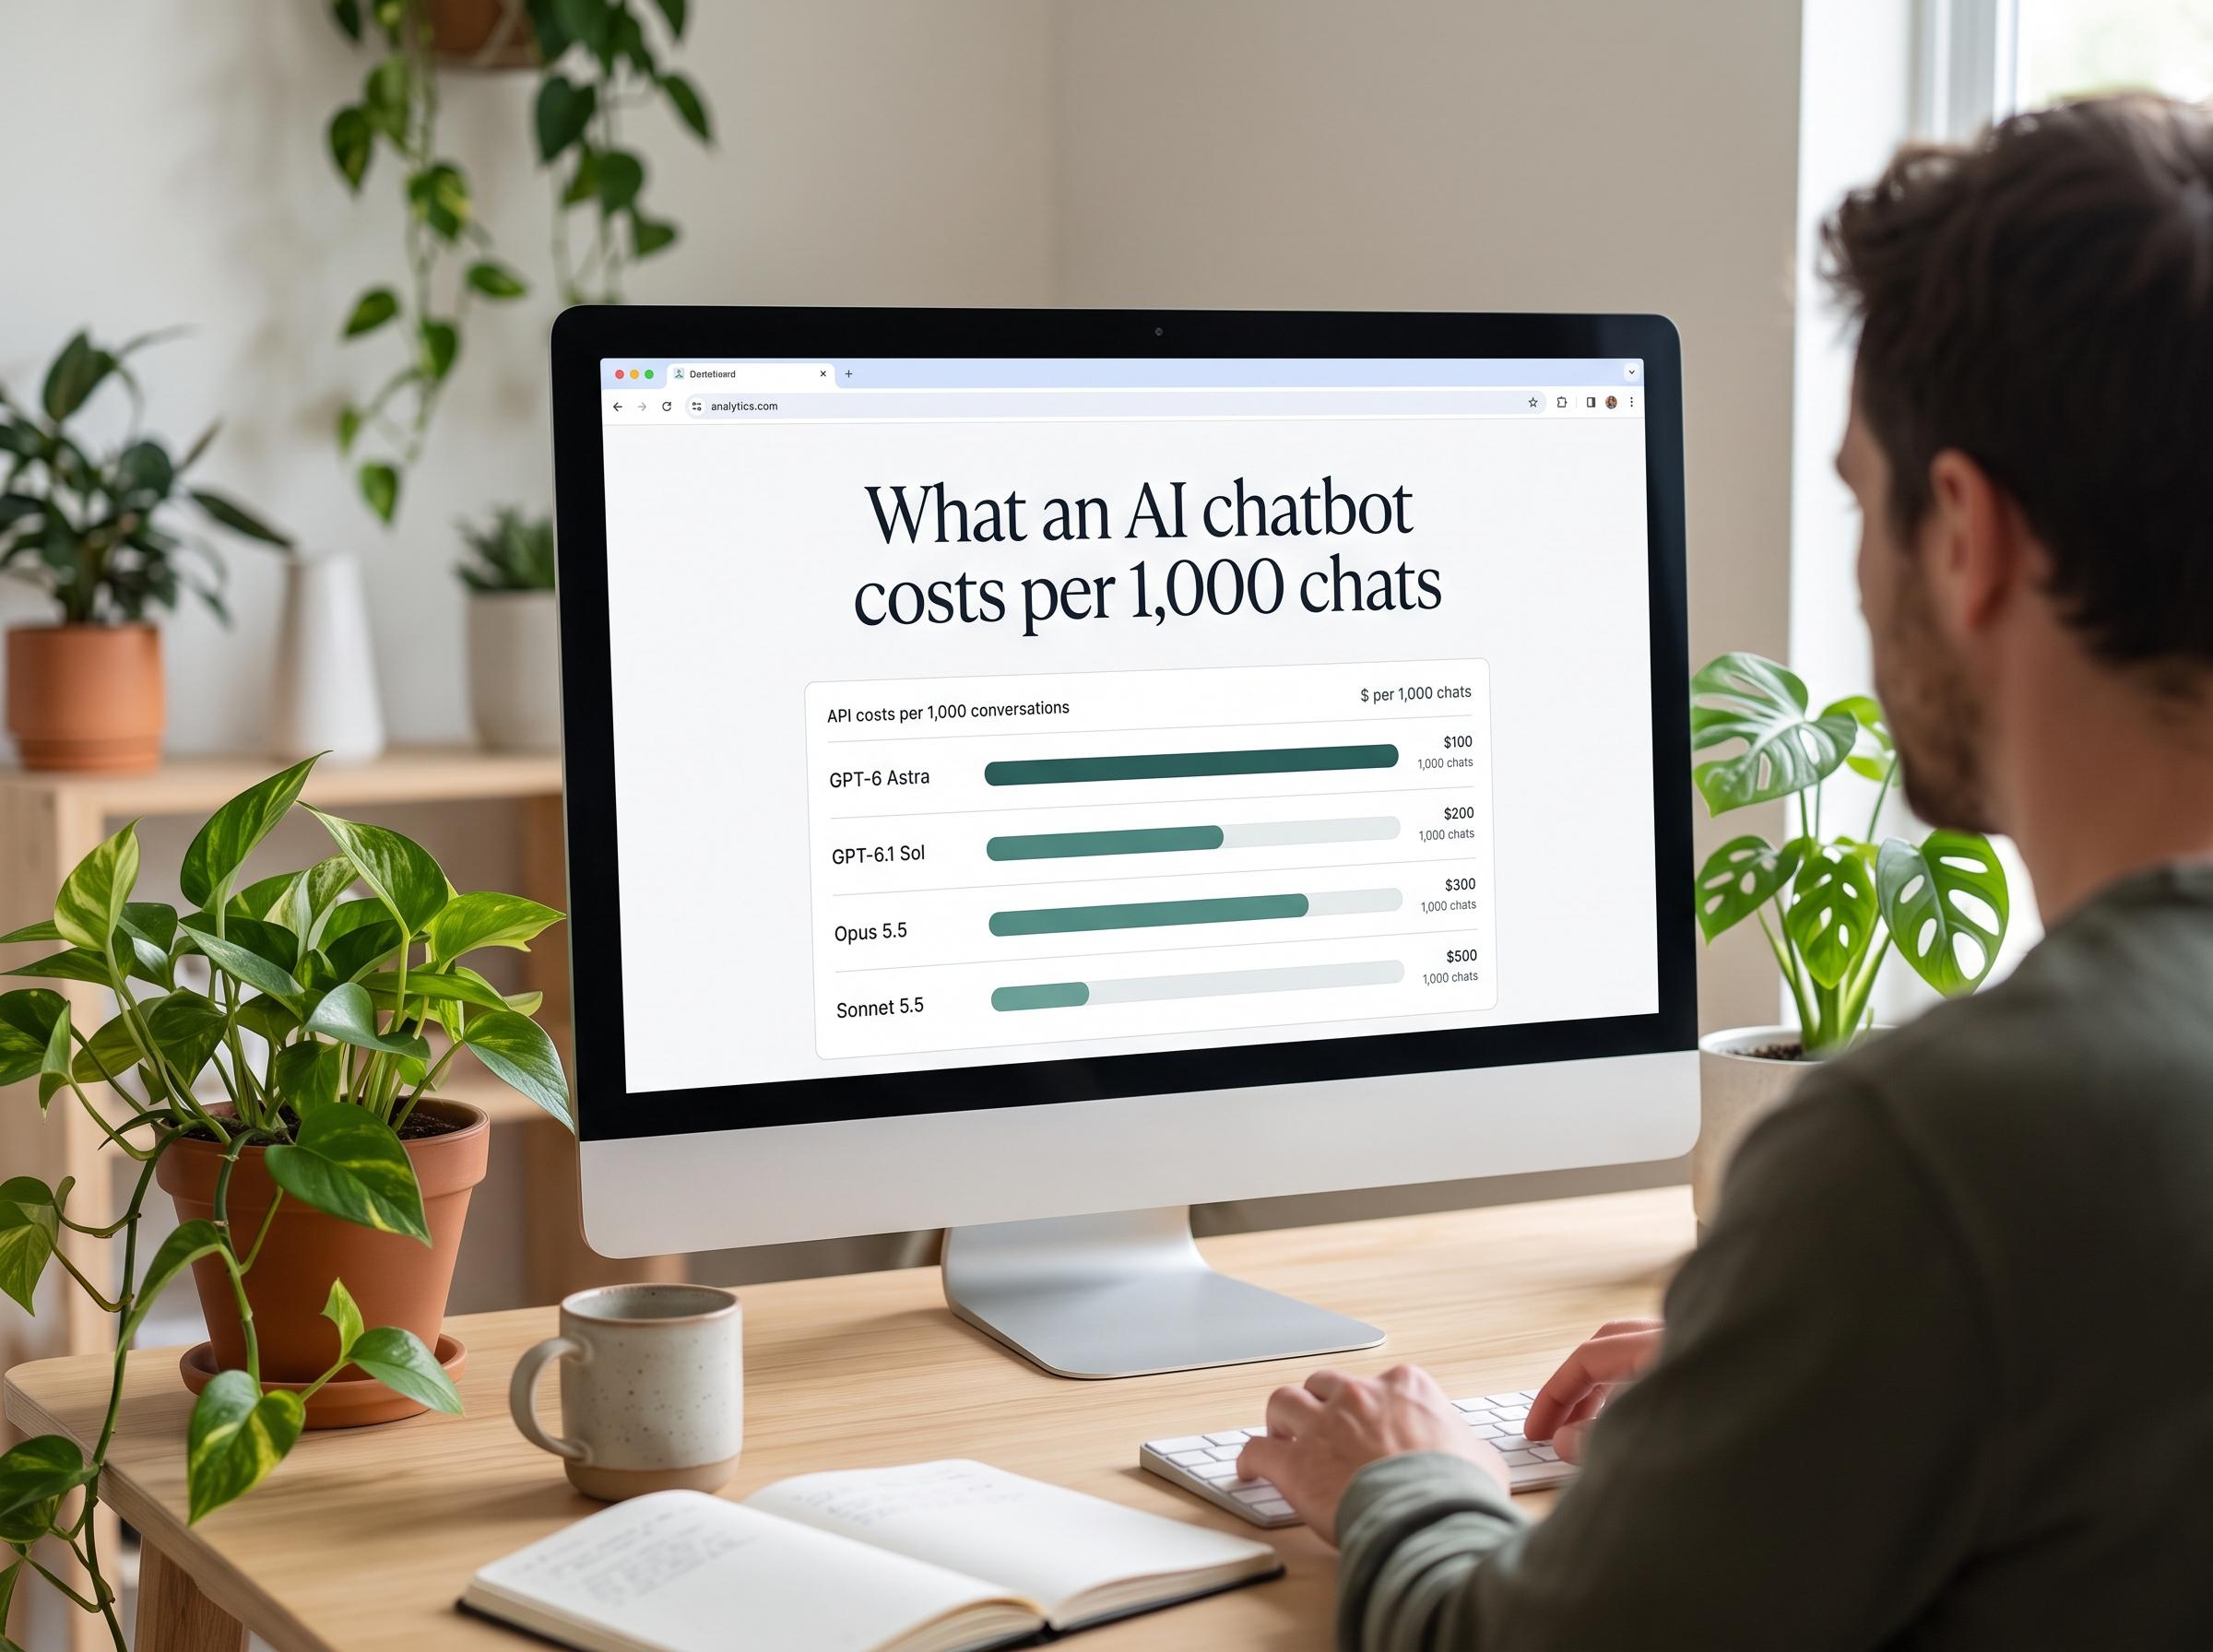
Zu Listenpreisen kosten 1,000 Chatbot-Konversationen mit 3,000 Input- und 500 Output-Tokens etwa 11 $ auf Claude Sonnet 5.5 oder GPT-6.1 Sol, 22 $ auf Claude Opus 5.5, 55 $ für GPT-6 Astra und etwa 55 Cent für GPT-6 Luna. Durch das Zwischenspeichern einer gemeinsamen Eingabeaufforderung wird jede dieser Zahlen um etwa ein Drittel reduziert.
Das ist nur die Musterrechnung, und sie ändert sich mit der Länge Ihres Gesprächs. Dieser Leitfaden zeigt die Funktionsweise, sodass Sie unsere Annahmen durch Ihre eigenen ersetzen können.
Die Annahmen
- 1,000 Konversationen, jeweils mit einem Modellaufruf von 3,000 Eingabetokens (Systemaufforderung, abgerufenes Wissen und die Frage des Benutzers) und 500 Ausgabetokens.
- Standardverarbeitung zu Listenpreisen in USD, ohne Chargenrabatt und ohne Langzeitzuschlag.
- Für die Caching-Spalte werden 2,000 der 3,000 Eingabetokens zum zwischengespeicherten Eingabepreis aus dem Cache gelesen. Der einmalige Aufwand für das Schreiben des Caches entfällt.
Echte Chats tätigen mehrere Anrufe und senden den Verlauf jedes Mal erneut. Behandeln Sie diese also als eine Etage.
Preise verwendet
| Model | Input per 1M | Cached input per 1M | Output per 1M |
|---|---|---|---|
| Claude Sonnet 5.5 | $2.00 | $0.20 | $10.00 |
| Claude Opus 5.5 | $4.00 | $0.20 | $20.00 |
| GPT-6.1 Sol | $2.00 | $0.10 | $10.00 |
| GPT-6 Astra | $10.00 | $1.00 | $50.00 |
| GPT-6 Luna | $0.10 | $0.01 | $0.50 |
Quellen: Anthropics Opus 5.5-Modellseite und OpenAIs API-Preisseite. Die Input- und Output-Preise von Sonnet 5.5 stammen aus der Modellvergleichstabelle von Anthropic; Bestätigen Sie den zwischengespeicherten Eingabepreis auf Anthropics eigener Sonnet 5.5-Seite.
Das Ergebnis
| Model | Per 1,000 chats | With caching | Per chat |
|---|---|---|---|
| Claude Sonnet 5.5 | $11.00 | $7.40 | about 1.1 cents |
| Claude Opus 5.5 | $22.00 | $14.40 | about 2.2 cents |
| GPT-6.1 Sol | $11.00 | $7.20 | about 1.1 cents |
| GPT-6 Astra | $55.00 | $37.00 | about 5.5 cents |
| GPT-6 Luna | $0.55 | $0.37 | about 0.06 cents |
Die Arithmetik für Sonett 5.5 ist (3,000 ÷ 1,000,000 × $2 + 500 ÷ 1,000,000 × $10) × 1,000 = $11. Tauschen Sie die Preise der einzelnen Modelle gegen die anderen ein.
Gemini 4 Argon wird weggelassen, da es nicht öffentlich verfügbar ist und die gemeldeten Preise widersprüchlich sind.
Was ändert die Nummer?
- Gesprächslänge. In jeder Runde wird der Verlauf erneut gesendet, sodass ein Chat mit zehn Runden weitaus mehr Eingaben sendet als ein Chat mit einer Runde.
- Caching. Ein zwischengespeicherter Lesevorgang ist viel günstiger als eine frische Eingabe, aber das Schreiben des Caches kostet mehr als eine normale Eingabe: 5 USD pro Million Token für einen fünfminütigen Schreibvorgang auf Opus 5.5 und 12.50 USD auf GPT-6 Astra.
- Denkmarken. Opus 5.5 verwendet immer adaptives Denken. Überprüfen Sie daher, wie Denktokens abgerechnet werden, bevor Sie einer Schätzung vertrauen, die nur auf der sichtbaren Antwort basiert.
- Charge. Beide Anbieter nehmen sich 50% frei für Arbeiten, die keine sofortige Antwort erfordern, wie zum Beispiel das Zusammenfassen der Transkripte von gestern Abend.
- Werkzeuge. OpenAI berechnet 10 $ pro 1,000 Websuchaufrufe zusätzlich zu den Tokens.
- Verbosity. Models use different amounts of tokens for the same task. On the Vals Index, Sonnet 5.5 cost $21.34 per test and Opus 5.5 cost $32.14, which is not the 2-to-1 gap their list prices suggest. Measure cost per task, not price per token.
Setzen Sie diese Ideen um.
Von einer gezielten Verbesserung bis zur kompletten Website: Wir helfen Ihnen, den Umfang zu klären und das Vorhaben umzusetzen.
Meine Website besprechenBenutzerdefinierte Web- und AnwendungsentwicklungTeilen Sie uns Ihre Ziele mit. Wir antworten in der Regel innerhalb von 4 Stunden mit Fragen und praktischen nächsten Schritten.
Was der Gesetzentwurf auslässt
Hosting, eine Wissensdatenbank oder ein Suchindex, Überwachung, Moderation, ein menschlicher Übergabepfad und Entwicklungszeit liegen alle außerhalb der Modellrechnung.
Erhalten Sie Ihre eigene Nummer an einem Tag
- Beispiel 50 echte Fragen aus Ihrem Posteingang oder Support-Tickets.
- Führen Sie sie durch das Modell und protokollieren Sie die Anzahl der Eingabe- und Ausgabetokens, die die API zurückgibt.
- Multiplizieren Sie den Durchschnitt mit Ihrem monatlichen Volumen und fügen Sie dann einen Puffer von 30% hinzu.
- Legen Sie vor dem Start in der Konsole des Anbieters ein monatliches Ausgabenlimit fest.
Häufig gestellte Fragen
Ist das günstigste Modell gut genug für einen Website-Chatbot?
Nur wenn es Ihren eigenen Test besteht. GPT-6 Luna kostet nur einen Bruchteil der anderen, aber billige Antworten, die falsch sind, kosten Leads. Testen Sie 50 echte Fragen, bevor Sie sich entscheiden.
Wird Caching die Kosten wirklich um ein Drittel senken?
Dies ist in diesem Beispiel der Fall, in dem zwei Drittel der Eingabe eine gemeinsame Eingabeaufforderung sind, die aus dem Cache gelesen wird. Ihre Ersparnis hängt davon ab, wie oft sich jede Anfrage wiederholt.
Kostet ein längeres Gespräch mehr?
Ja. Der gesamte Verlauf wird bei jeder Runde erneut gesendet, sodass die Eingabetoken mit jeder Nachricht wachsen, es sei denn, Sie kürzen oder fassen sie zusammen.
Planen Sie einen Chatbot für Ihre Website?
Die Modellauswahl ist ein Einzelposten. Wir entwerfen den gesamten Build, vom Abruf und den Leitplanken bis hin zur Protokollierung und Ausgabenlimits, für WordPress und Next.js Standorte. Sehen Sie sich unsere an KI-Integrations- und Chatbot-Entwicklungsdienste.